Локальные языковые модели проверили на C, микроконтроллере, графике и проектировании плат
Автор технического эксперимента на Habr сравнил локальные LLM не по общим тестам, а на наборе практических инженерных задач. Модели писали консольную программу, ускоряли вычисления для ESP32-S3, создавали графику и пробовали проектировать электронные устройства. Результаты оказались заметно разными.
Главное
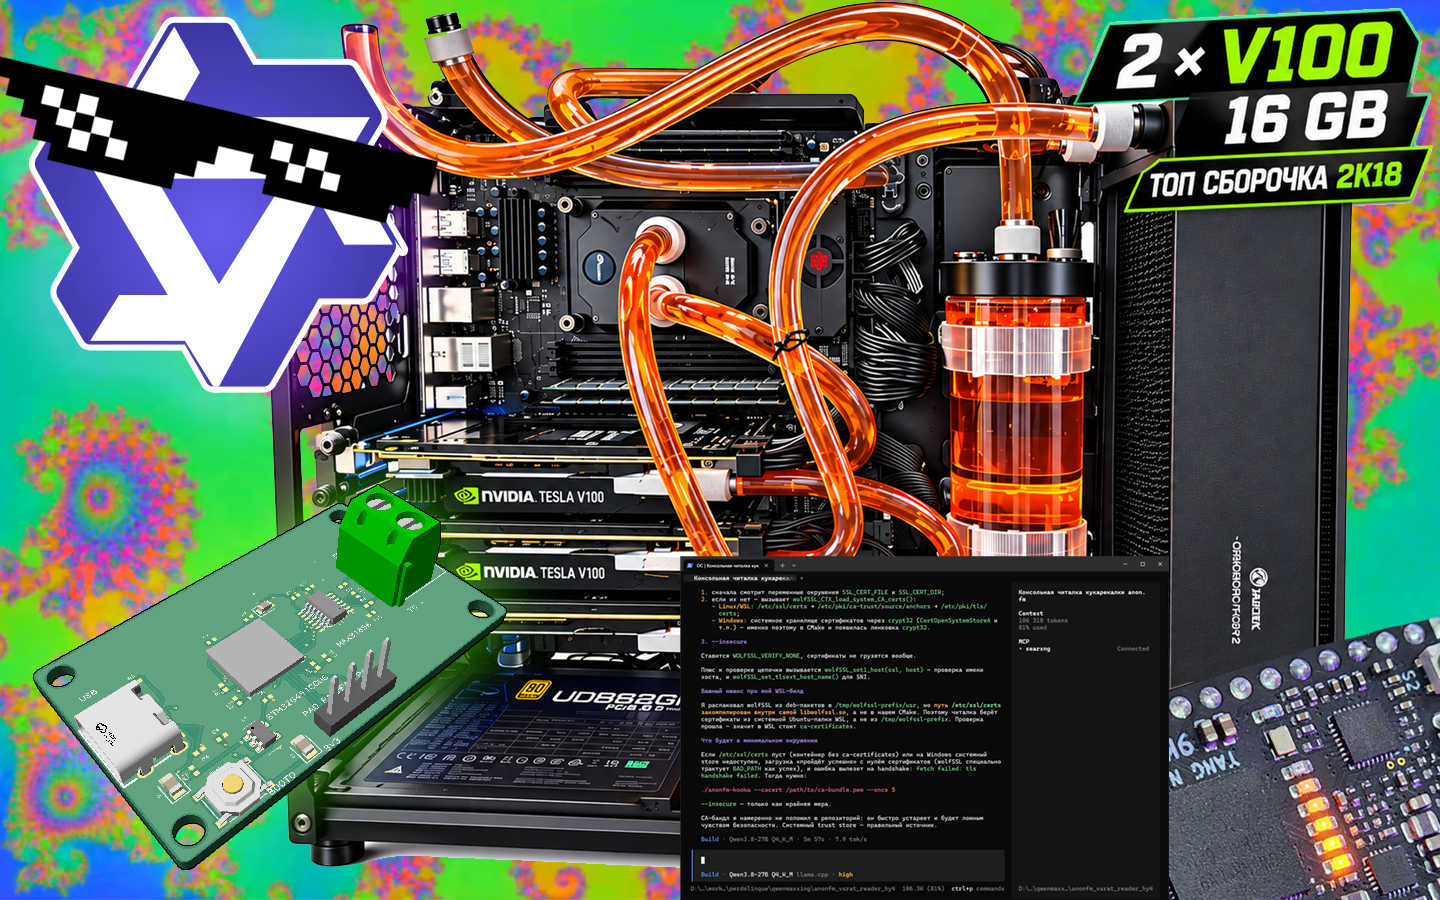
Исследователь собрал домашнюю систему с процессором AMD EPYC и двумя ускорителями Nvidia V100, чтобы запускать крупные модели локально. В эксперименте участвовали варианты Qwen и GLM, а отдельные задания автор сравнивал с другими доступными ему моделями. Это личный инженерный опыт с конкретным оборудованием, а не стандартизированный независимый рейтинг. Поэтому любые заявленные показатели скорости и качества надо читать с учётом конфигурации, выбранных запросов и способов проверки.
Первой практической задачей стала консольная программа на ANSI C, читающая сообщения с веб-сервиса. Требовалось самостоятельно определить интерфейс, реализовать защищённое соединение, цветовой вывод пользователей и сборку под разные операционные системы. По описанию автора, несколько моделей смогли получить работающий результат, но некоторые ошиблись с библиотекой безопасности или не завершили сборку. Такой тест показывает, что формально похожий код ещё не равен проверенному исполняемому продукту.
Подробности
Следующий этап был связан с ESP32-S3: агентам поручили ускорить движок запуска небольшой языковой модели, используя возможности процессора и программную среду ESP-IDF. В статье приводятся результаты отдельных вариантов Qwen и GLM, причём более удачные изменения автор проверял сравнением вычислений с исходной реализацией. Здесь важна не только скорость вывода, но и сохранение корректных результатов. Обобщать отдельные замеры на все микроконтроллеры или другие модели было бы неверно.
В графических испытаниях агенты создавали пролёт по фракталу Мандельброта с использованием GPU. Неоднозначное требование сочетать старый стандарт языка C и современные графические вычисления модели решали по-разному: применяли инструменты CUDA, шейдеры либо низкоуровневый код. По наблюдениям автора, качество траектории и изображения заметно отличалось. Это наглядный пример того, почему визуально впечатляющая демонстрация нуждается в проверке исходного кода и соблюдения технического задания.
Что это меняет
Финальная часть эксперимента охватывала логику на Verilog для платы Tang Nano и попытку разработать печатную плату с помощью tscircuit. С программируемой логикой модели справились лучше, чем с разводкой и ориентацией физических компонентов: в проектах обнаружились ошибки посадочных мест и разъёмов. Общий вывод автора осторожен: локальные агенты могут приносить пользу в конкретных проверяемых задачах, но результаты, связанные с реальным оборудованием, нельзя принимать без инженерной приёмки.
Первоисточник
Материал подготовлен STRUCTURE по открытой публикации Habr. Текст и иллюстрации первоисточника не воспроизводятся целиком.